
关于自己的agent-harness的实践与迭代过程中一些好玩的点
无广告,手打,比较乱. 我是看代码, 翻到哪写哪. 为了避免任何意义上的广告或泄露行为(基本自用, 不想找麻烦), 我会打码比较多, 见谅. 现在当claude限速了, 改点小玩意, 会试试自己的. 大任务还是不太放心.
其实基本就是现在agent的harness框架,大部分都是抄codex和claude code的理论和方法.
桌面端用wails写的.
有时候我会问claude它自己有哪些工具,可以放到我的agent (笑)
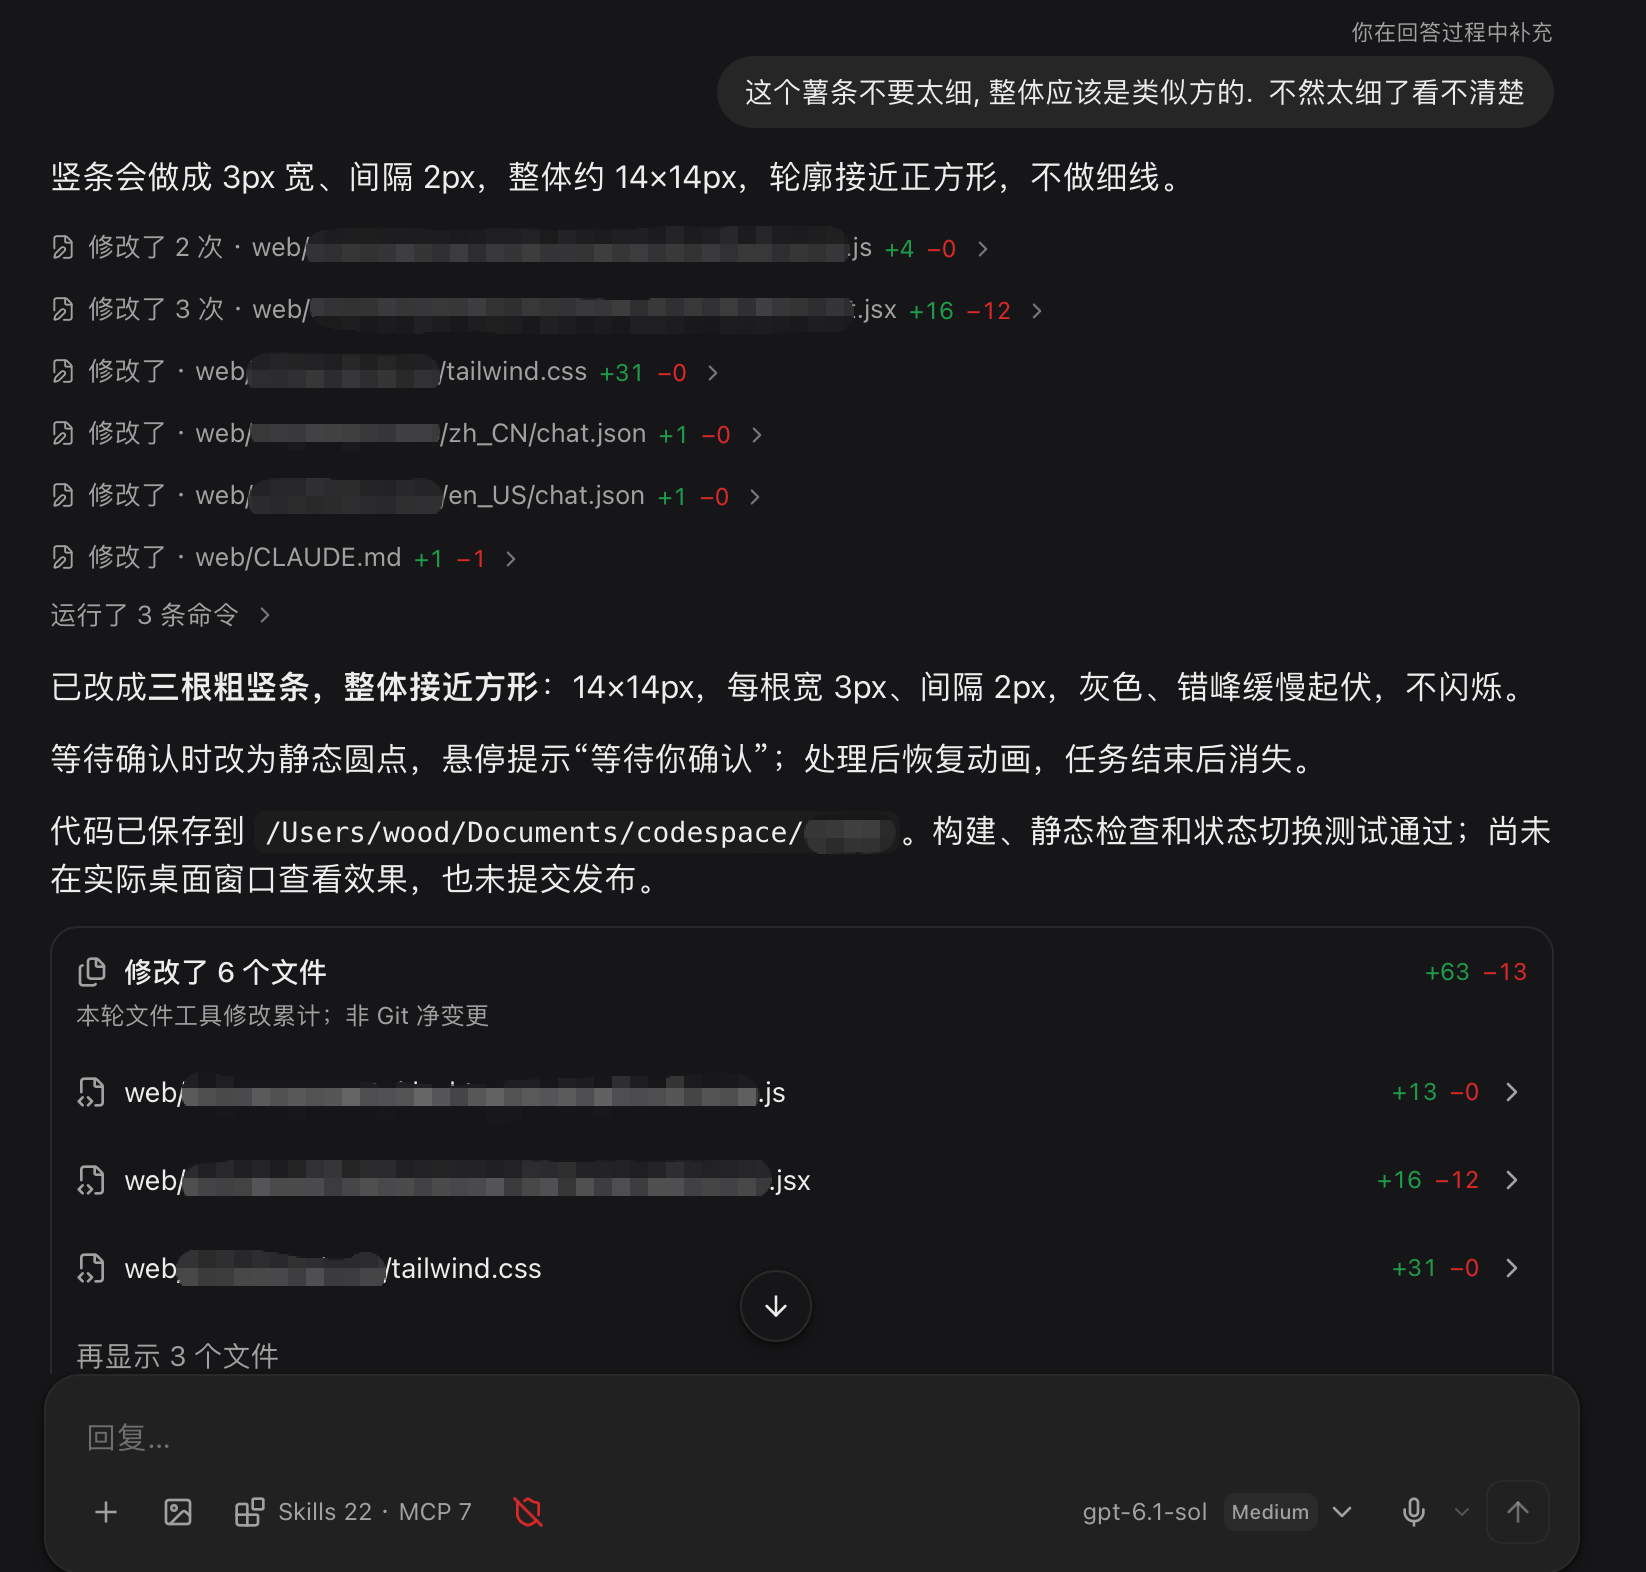
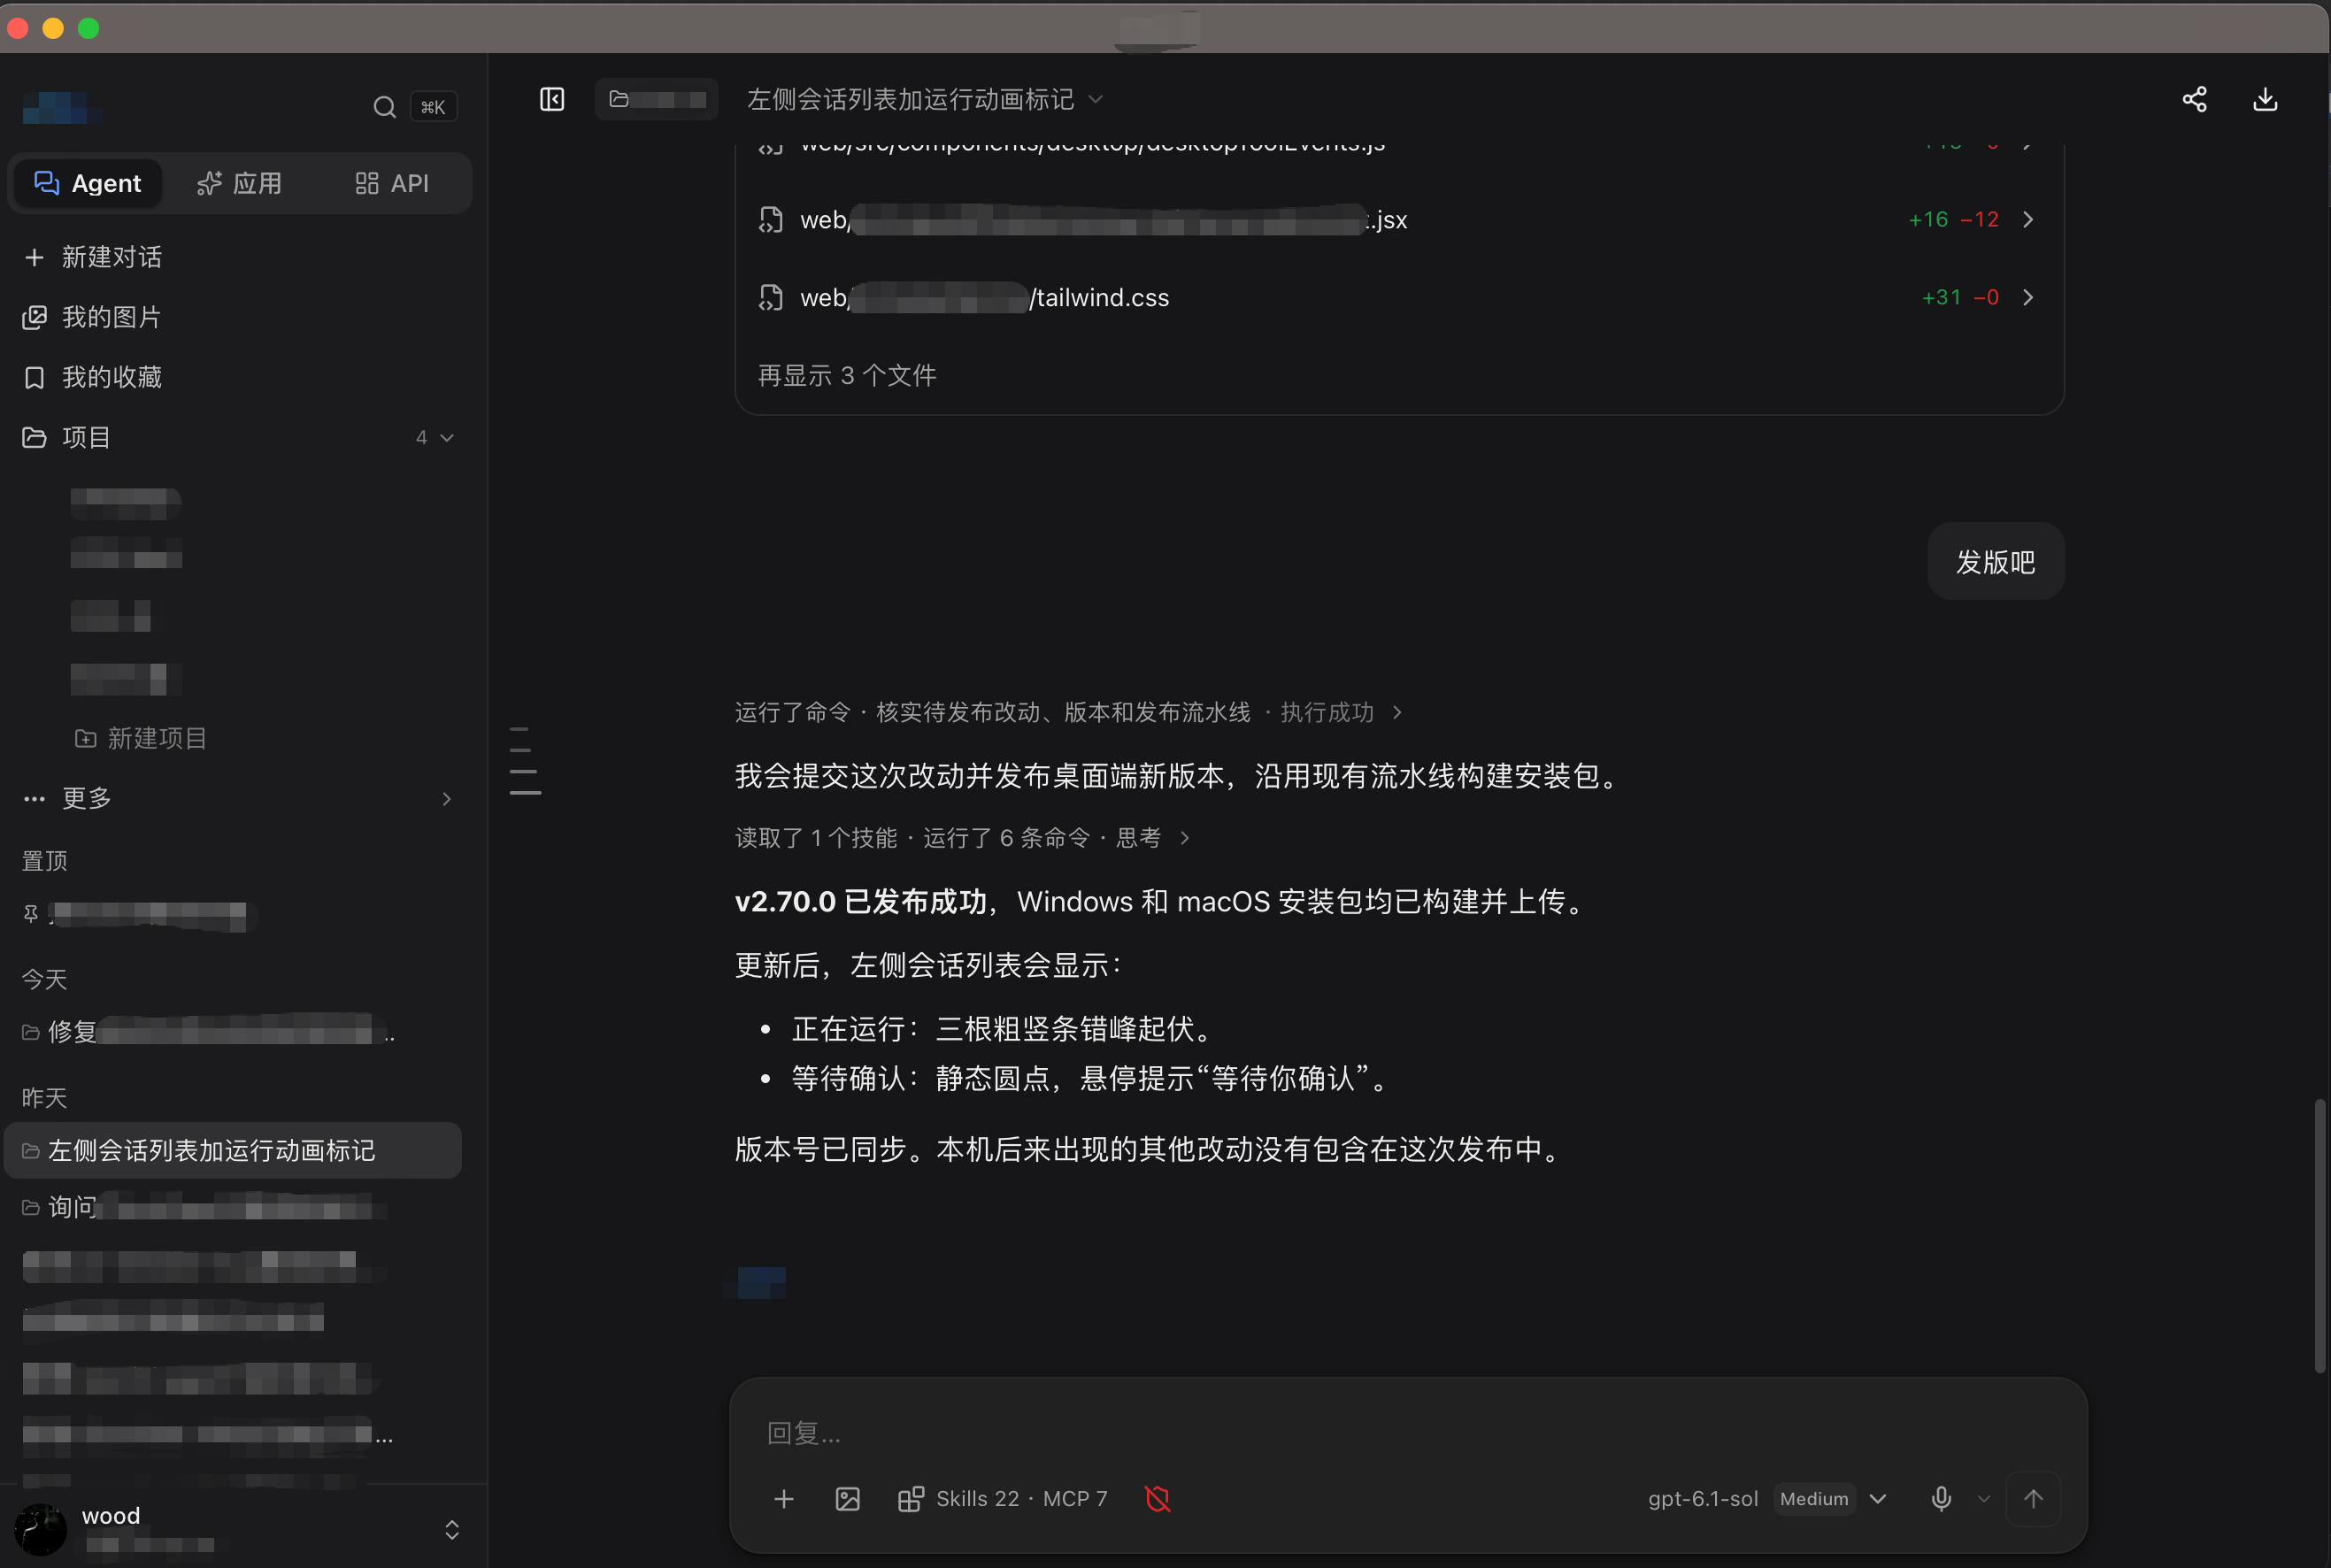
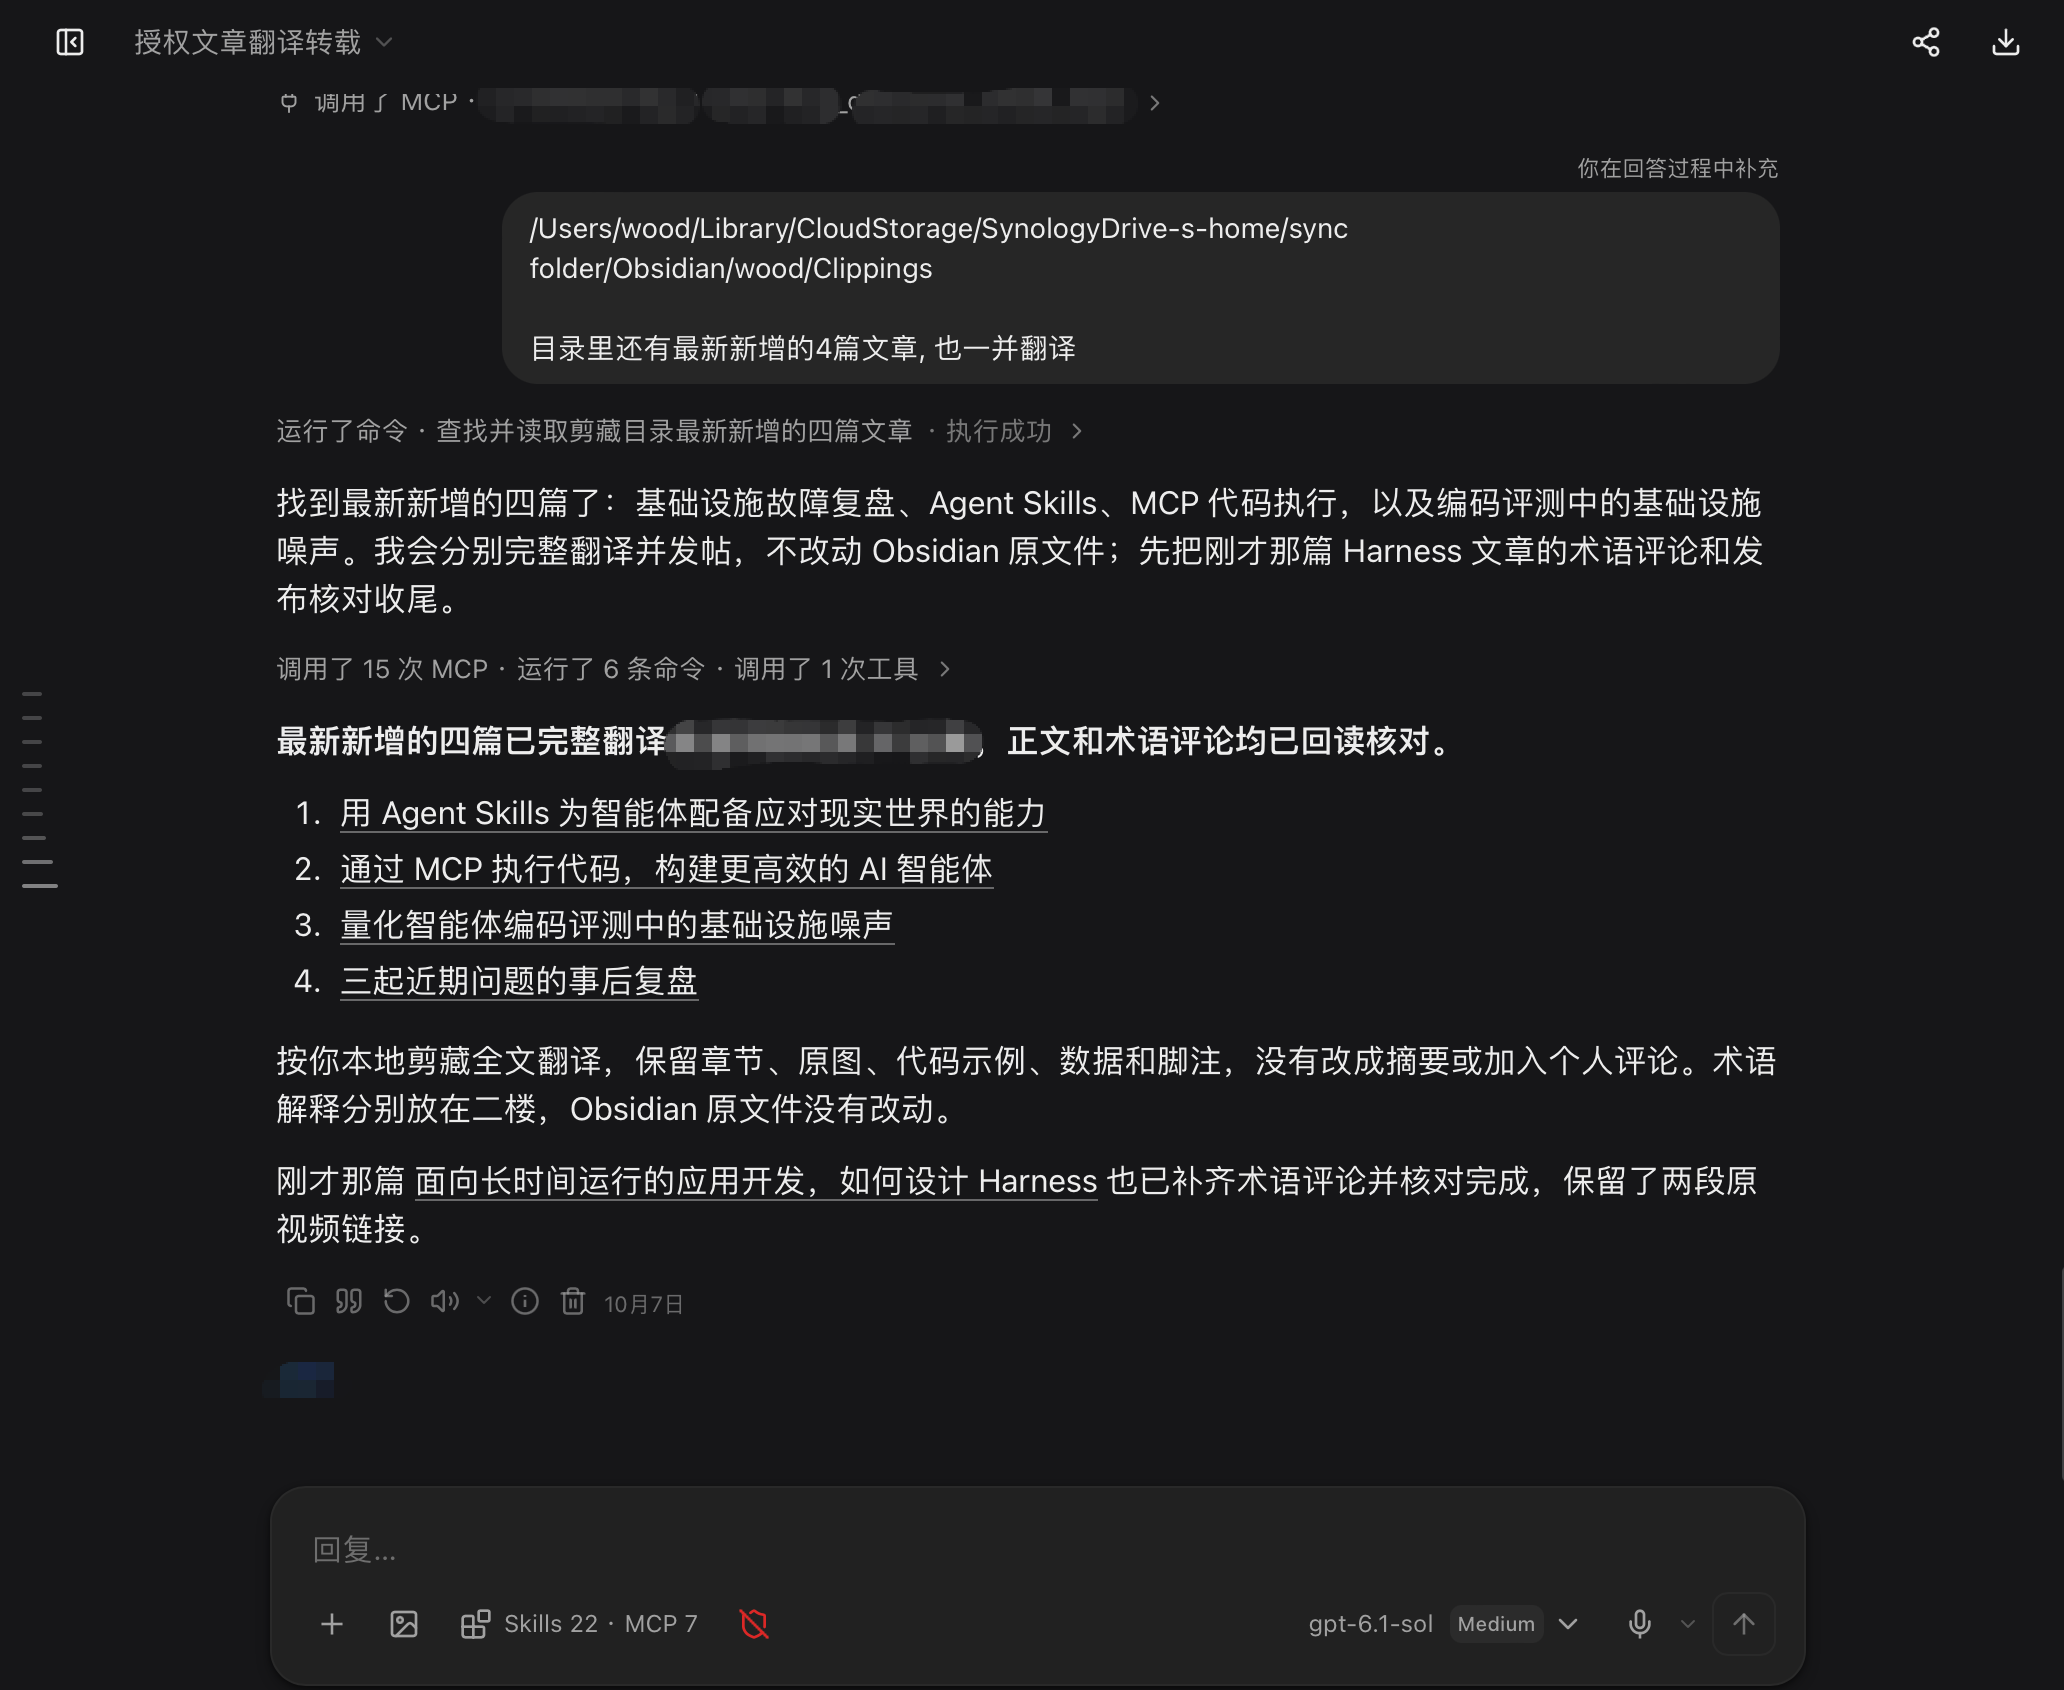
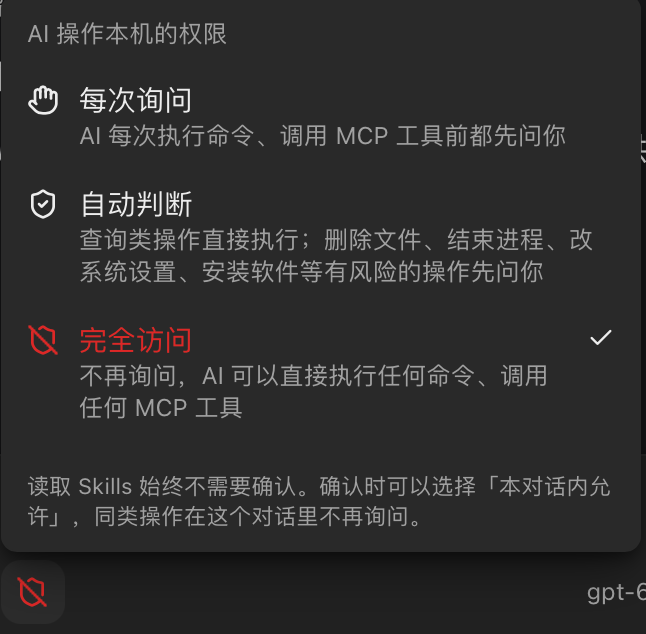
先放几个图
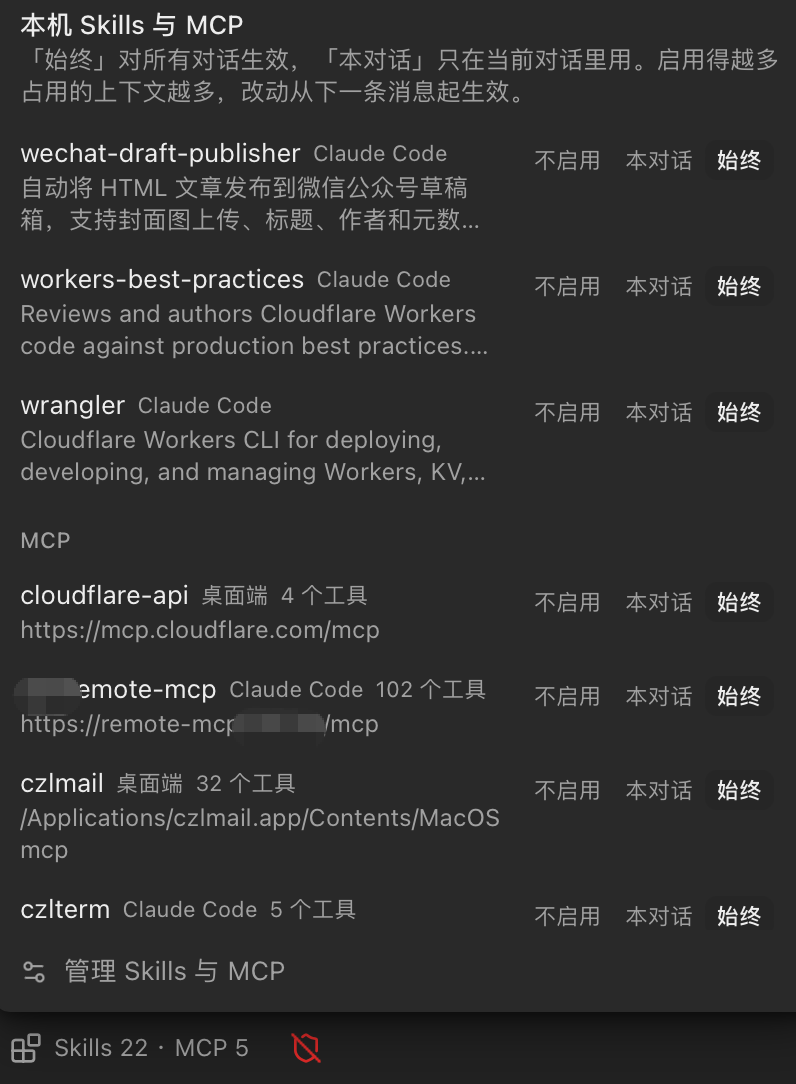
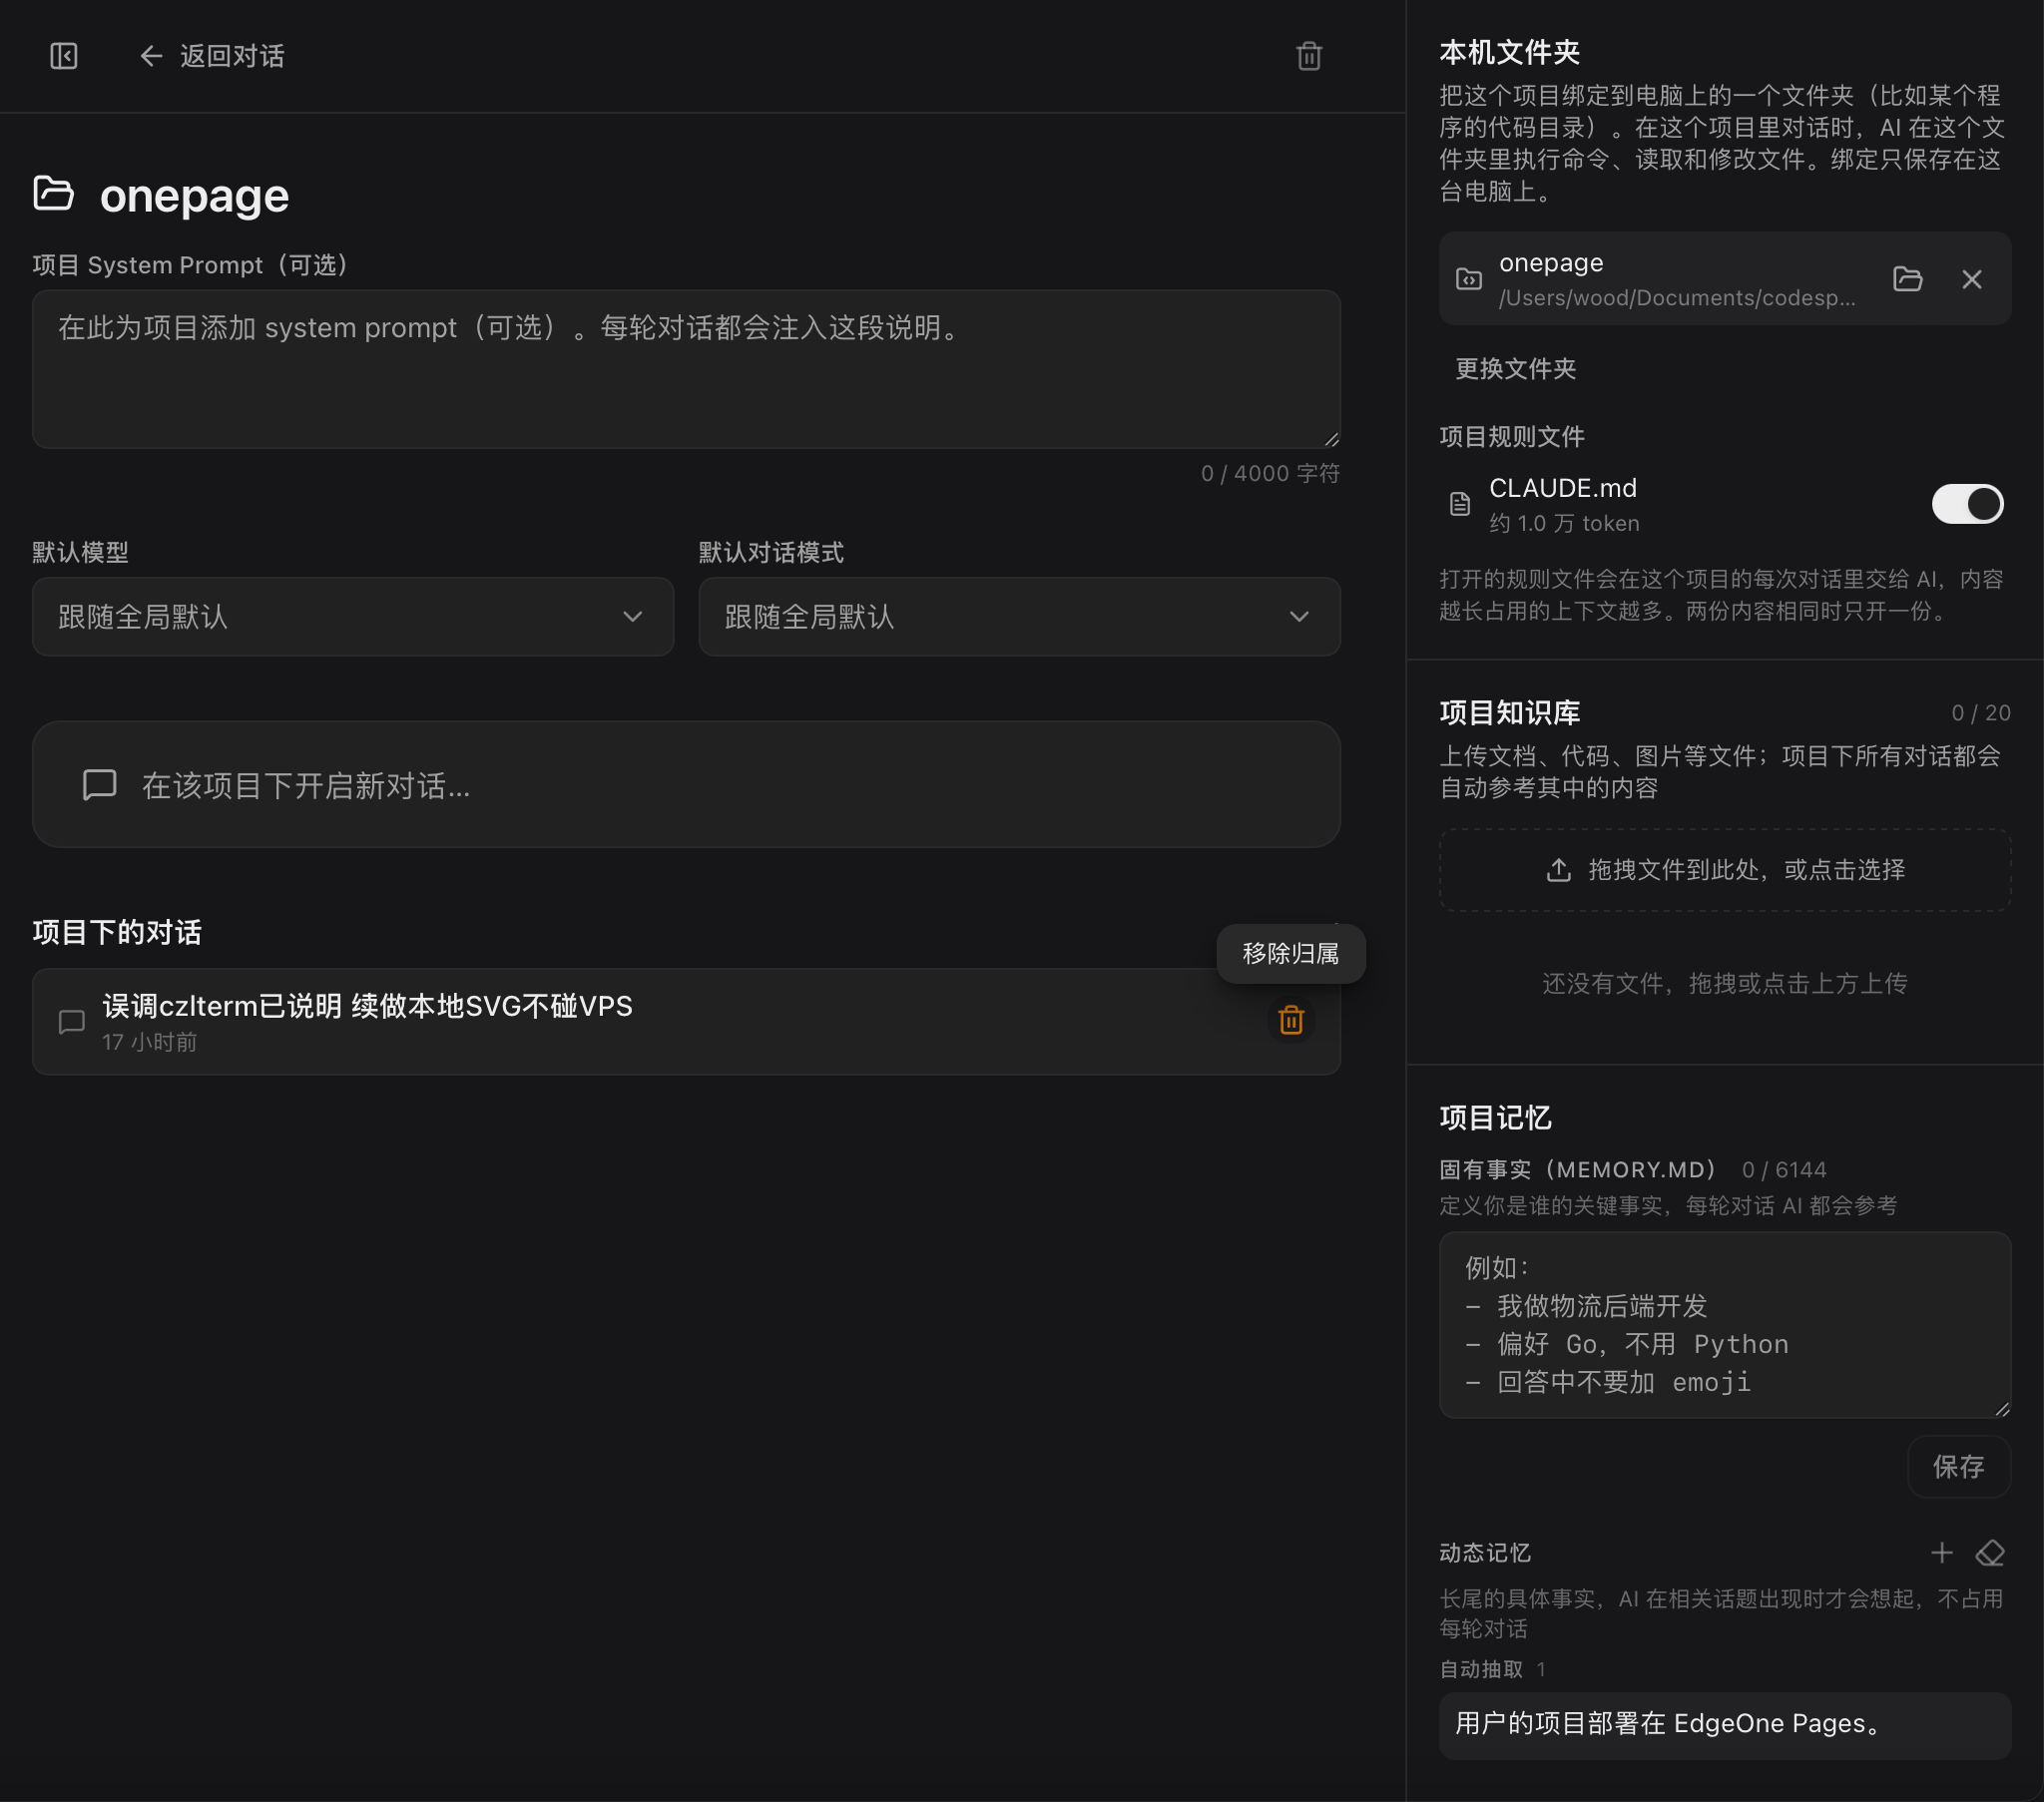
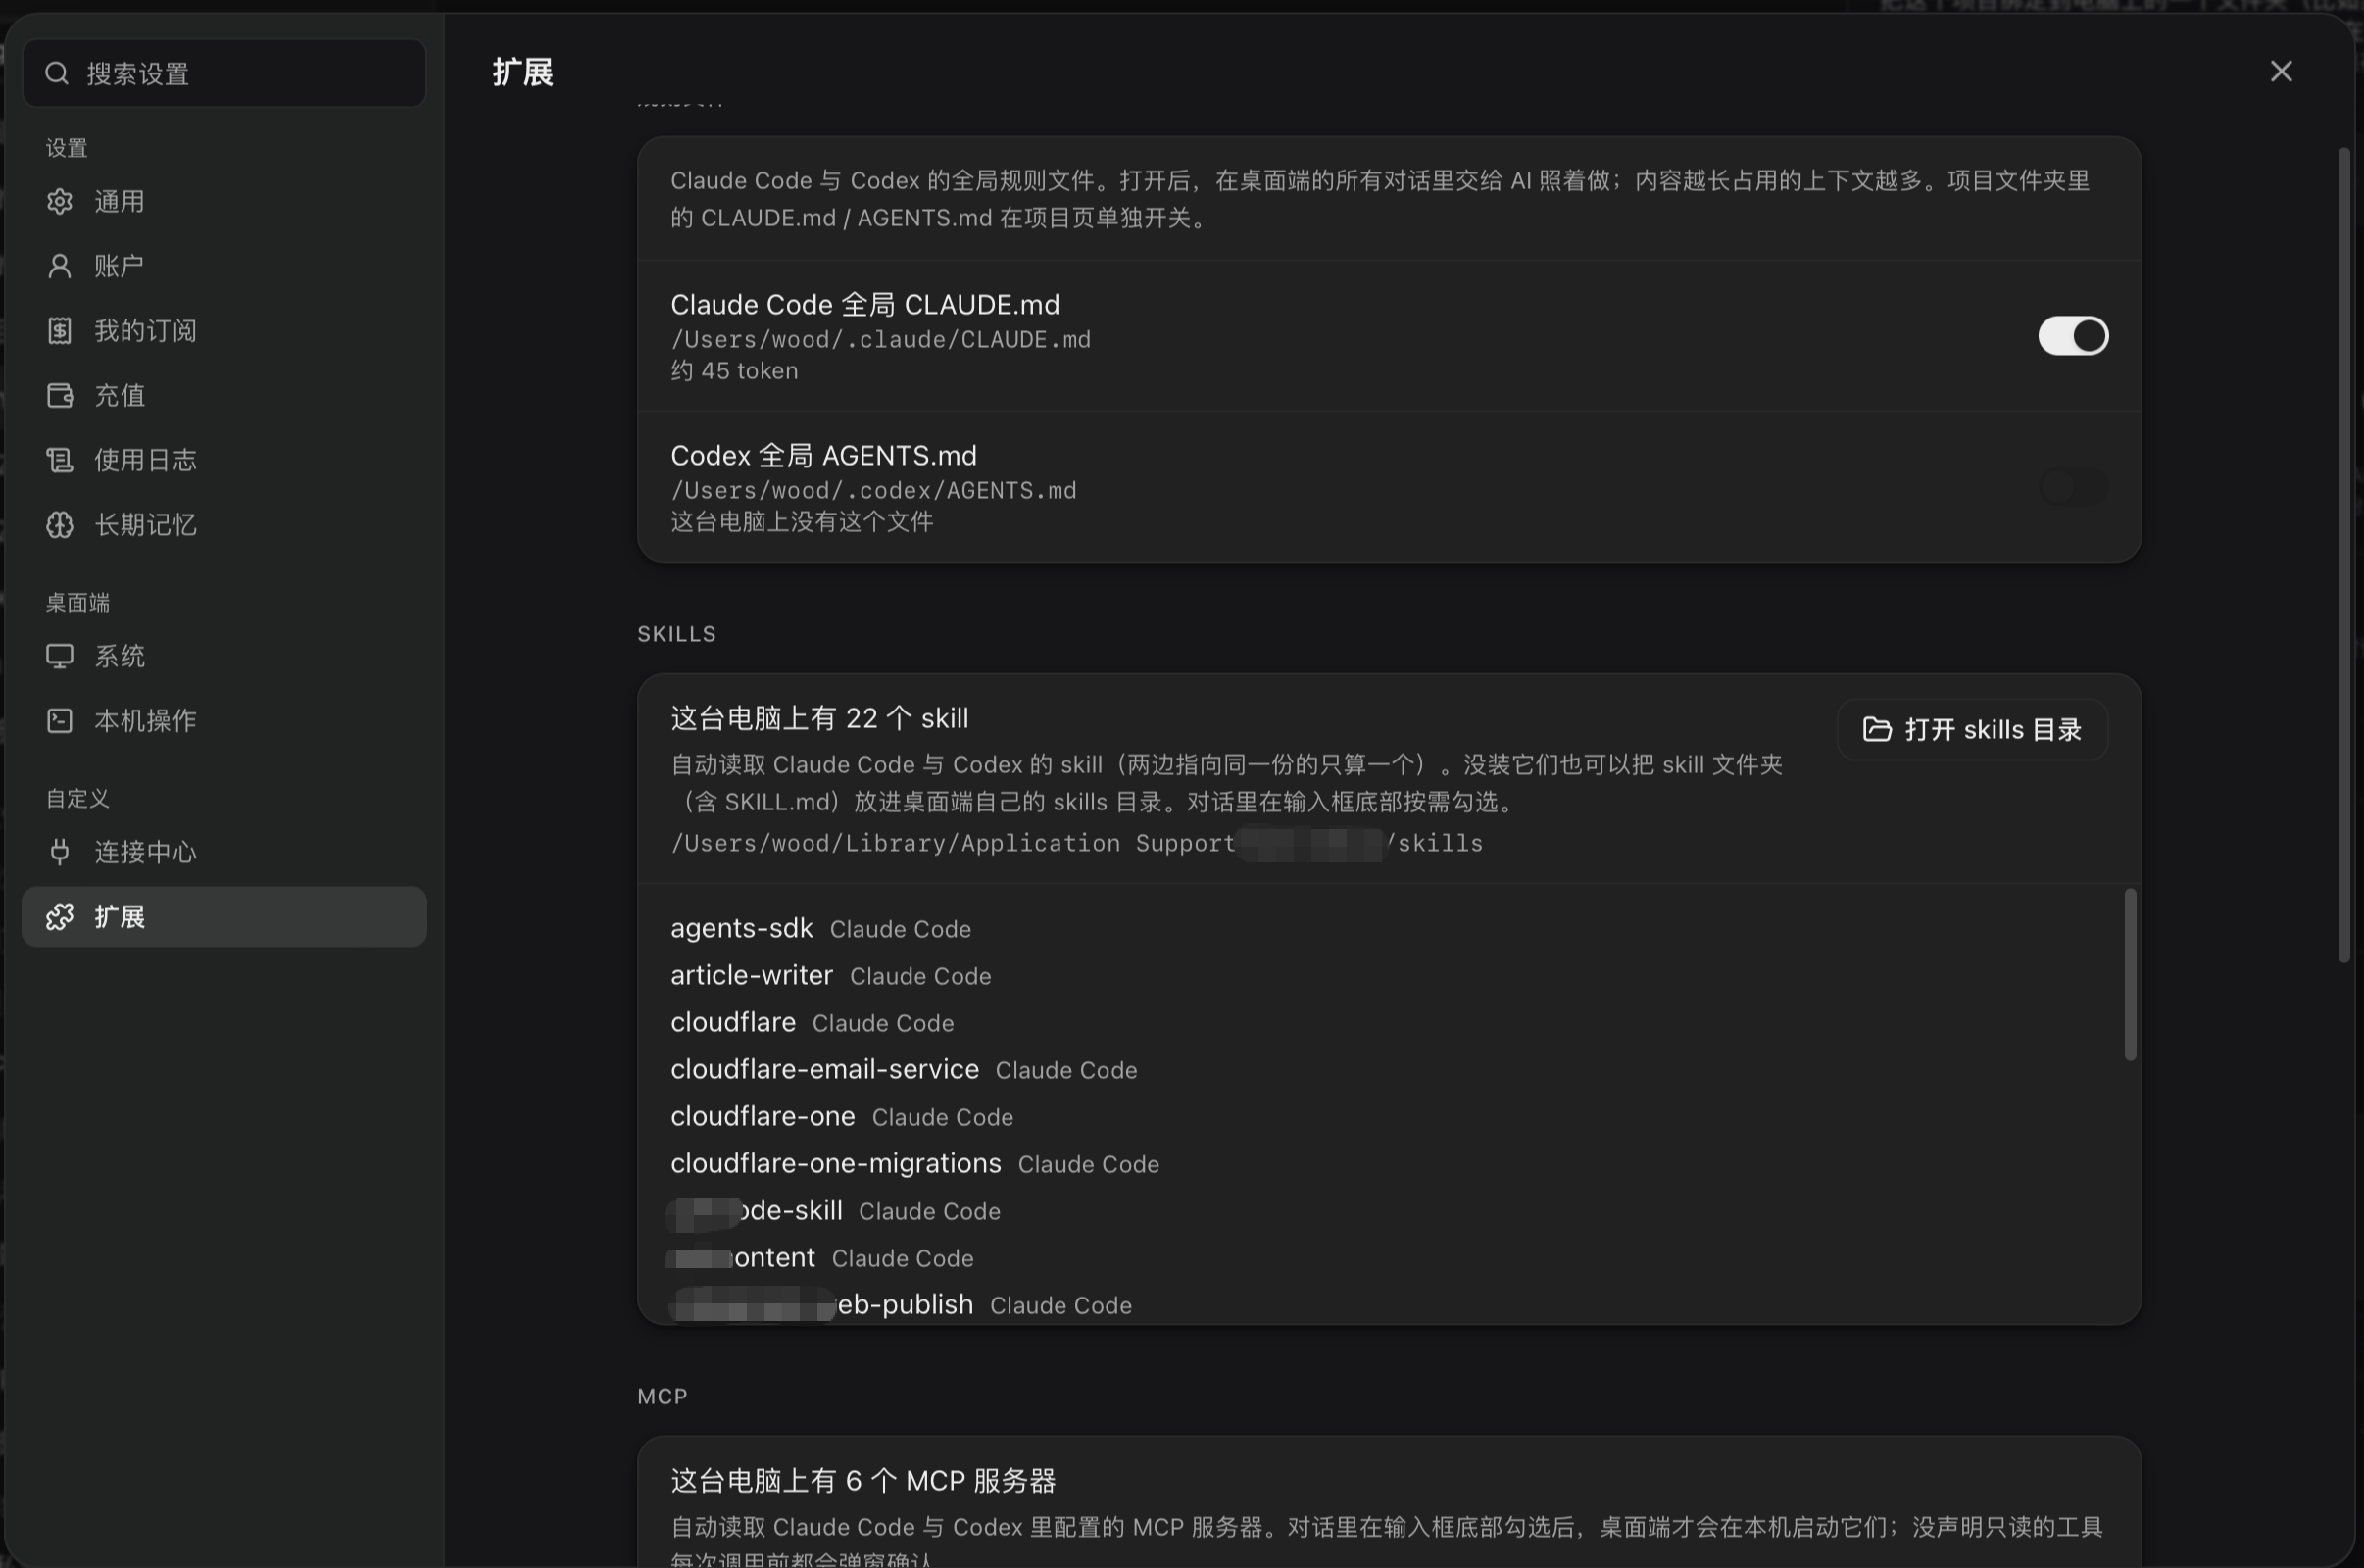
主要理论
给agent的tool
这个是基础, 比如ask_user_choice, memory, call_mcp, workspace, read image, save file, send file等等, 没有tool就啥都干不了.
调用tool的方法
一般是round trip, 让agent可以循环, 下一步做什么让agent自己决定.
tool的反馈
tool要给result, 无论任何情况, 比如停止, 暂停, 错误, 成功等等, 不然agent无法知道情况, 无法继续.
agent进程要能后台运行
不能必须在页面才能运行, 以前是通过前端去反馈result, 给后端持续调用. 发现不行, 如果切换到没挂载组件的任何前端其他页面, 都会导致任务暂停, 不如做本机程序后端去持续进行, 需要用户干预or完成时, 发系统级通知.
避免失控,人为干预, 推理记忆
- agent要有上限, 每次运行都有交付, 我理想的是以后不设硬上限, 交给decisions 模型去判断.
- 人为干预: 重要操作需要人来把控(例如可用ask_user_choice), 人的指令高于agent的规划. 所以人可以主动干预计划, 停止工作等.
- 推理记忆: 这个不能丢, 不然agent老是忘事.思维链和工具调用要对应, 不然会混乱.
四重记忆
这个我没做harness框架和桌面端时就做了, 纯网页对话也需要记忆. 之前好像发过贴, 忘了, 基本就是普通的rag 4重记忆.
只要不要影响缓存前缀就好了, 不然缓存总是丢成本很高
上下文工程
正好提到缓存, agent里要注意静态缓存和动态内容, 需要剥离.
- prompt需要分层组装.
- 上下文压缩要渐进式
- 工具也是渐进披露, 不然一次性塞上下文, 占的太多, 大部分在某些工作中用不上, 还影响注意力.
网页端的话, 需要远程沙箱
网页端也需要提供office三件套文件的生成功能, 一般都是skills+ai写python脚本来实现.
这个脚本, 我是用 远程机器(非项目主机器) + 固定容器(提供接口, 可唤起临时容器) + 临时容器(一次性执行沙箱, 做完销毁) 来跑的.
很有必要, 放本机跑=等死.
本机运行环境
在桌面端安装后一段时间, 安装一个自己用的python独立环境. 不用机器上的主python.
生态互通
claude, codex的已有工具, 提示词, 通通都要能用, 可以无缝接入.
也就是还懒得做, 不然可以把claude的memory文档都自动给导入, 更无缝, 严丝合缝.
安全工程
主要就是防止任何情况的外部信息影响agent安全. 毕竟agent是在本地电脑跑的.
方方面面, 每个环节都需要加.
结语
下面这个图是让claude给我写的. 擦, 他说我后端api有一些one-api的影子, 不能写api部分全自研, 改成了"重新设计实现". 很尊重版权和事实了.
实际基本把one-api原有代码改了70%以上了, 居然还能认出来.
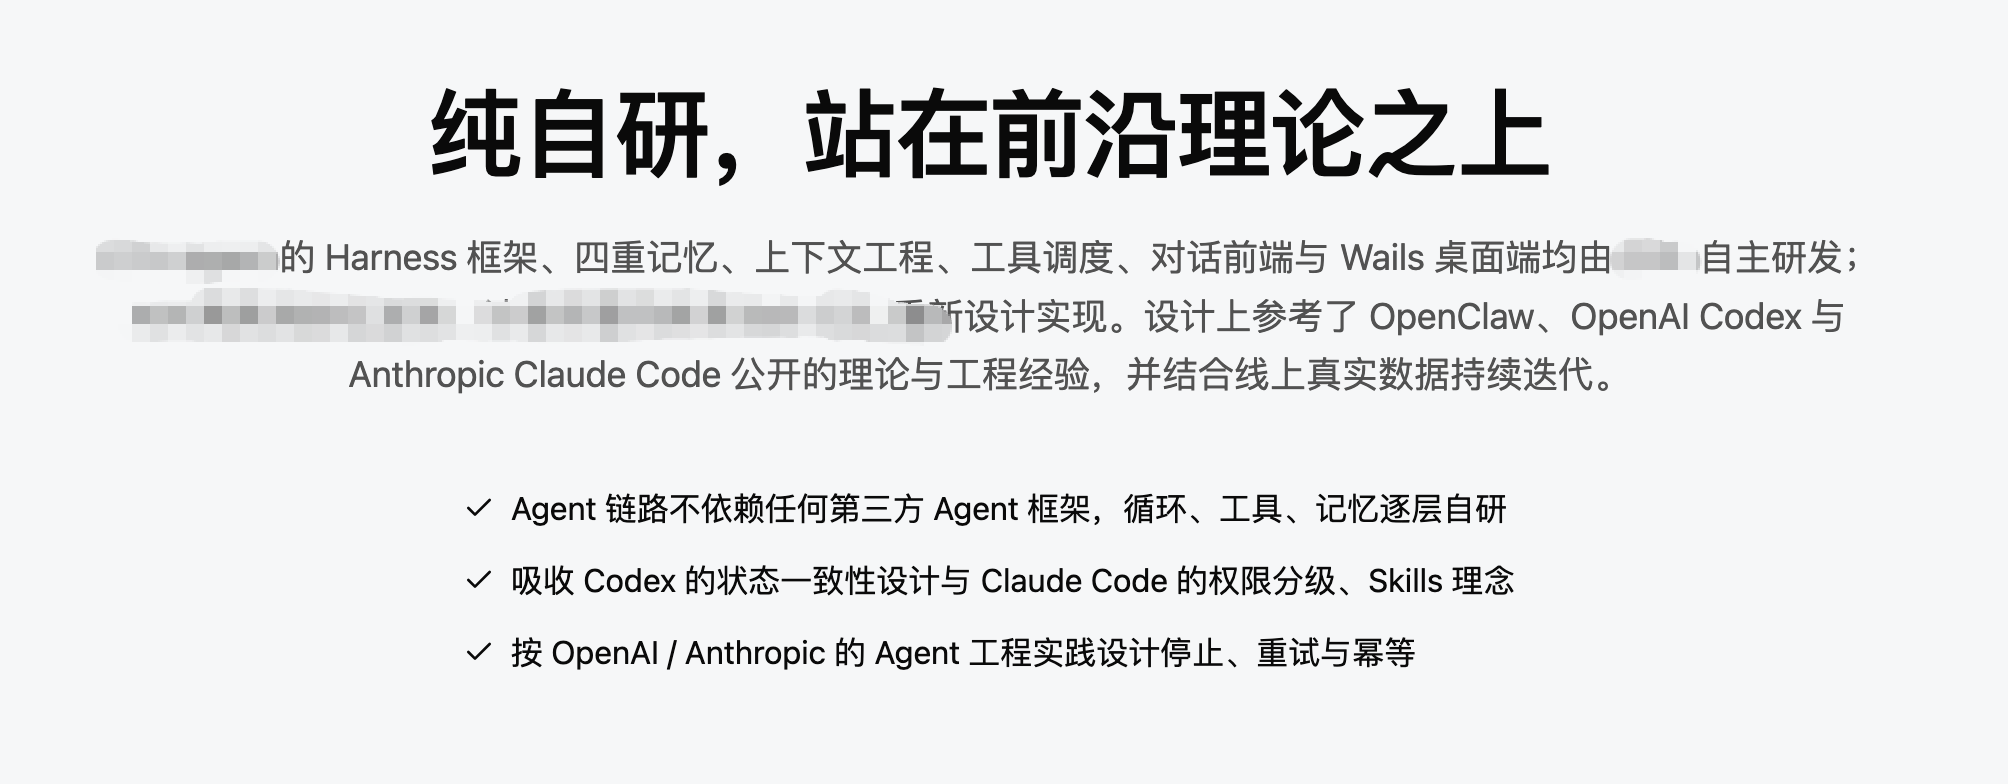
做这个主要是兴趣, 做了一个能用的工具, 当它帮我写代码和调mcp发文章, 在老婆电脑上装一下用于排查电脑故障等等时, 很有成就感.
评论 0