
llmfit:一条命令告诉你,这台电脑能跑哪些本地大模型
想本地跑大模型的人,十有八九踩过同一个坑:看中一个模型,下了十几 GB,加载时显存爆了,或者勉强跑起来每秒只蹦两三个字。llmfit 想解决的就是下载之前的这一步判断:它读你的硬件配置,告诉你哪些模型能跑、大概跑多快。这两天它冲上了 Rust 趋势榜。
它解决什么问题
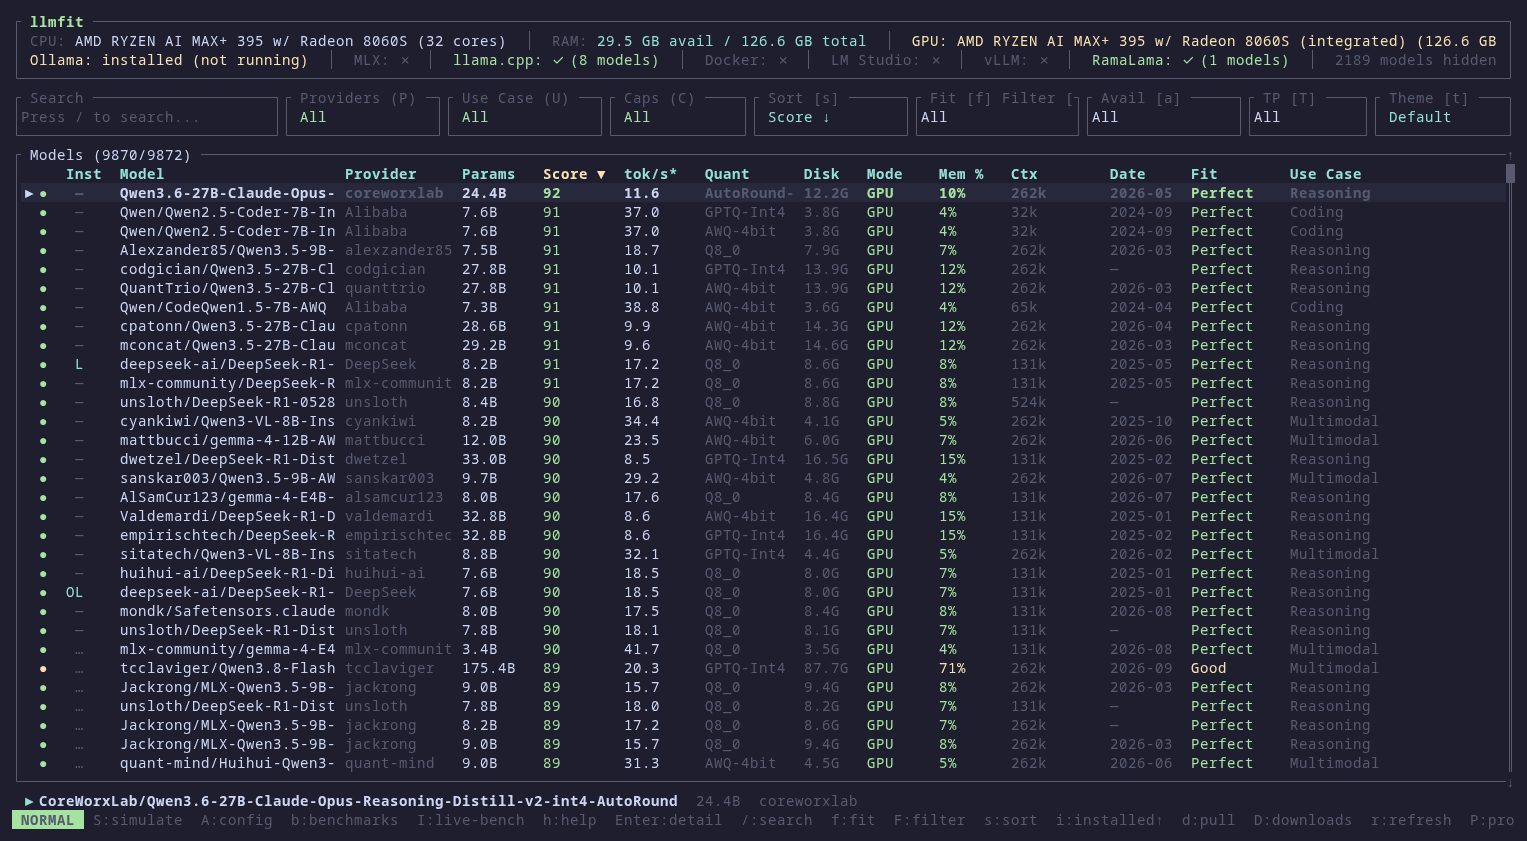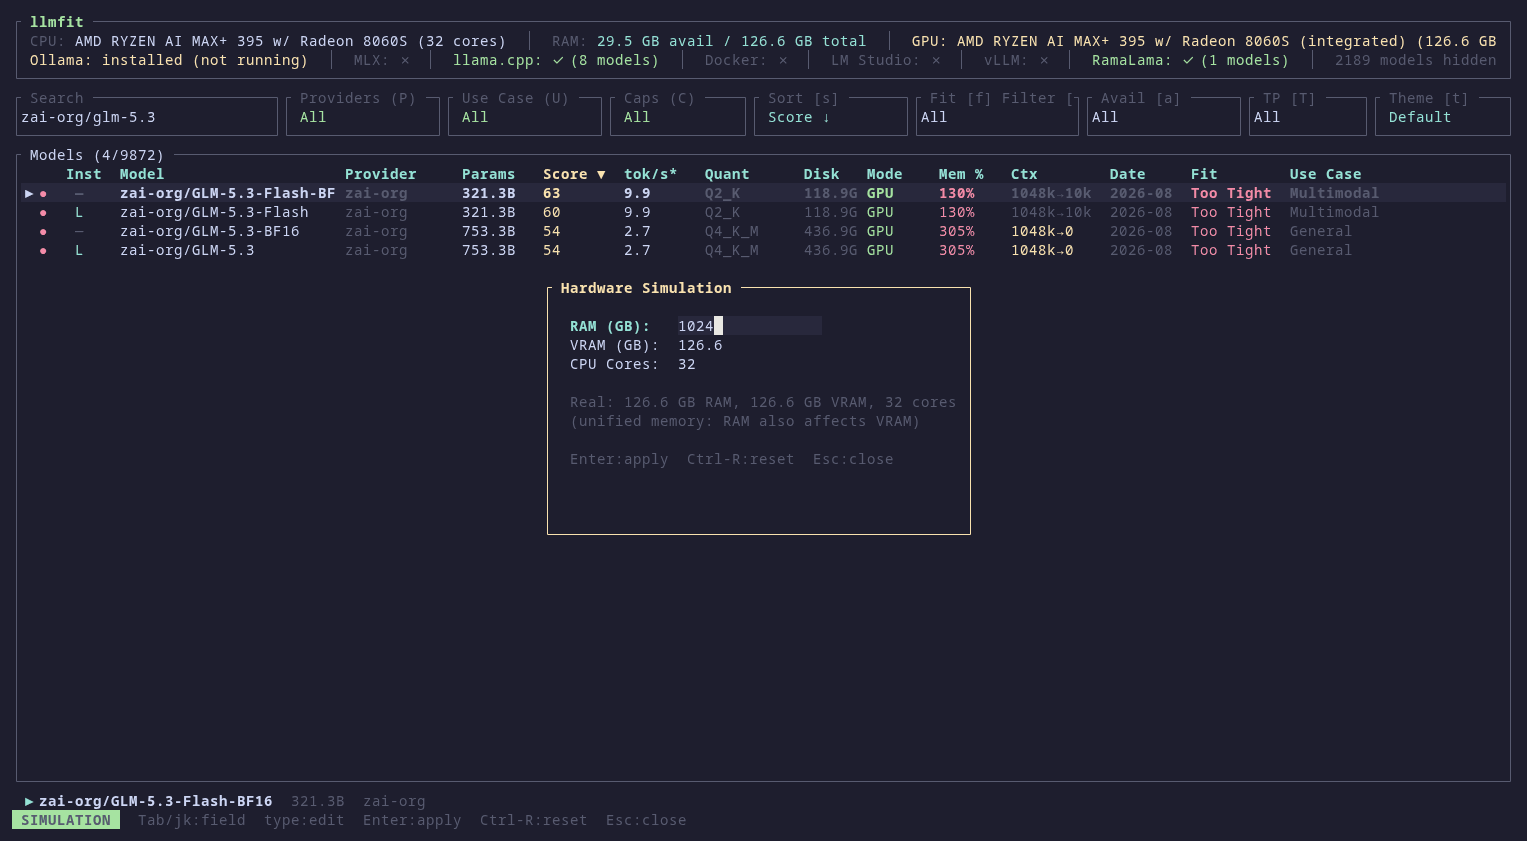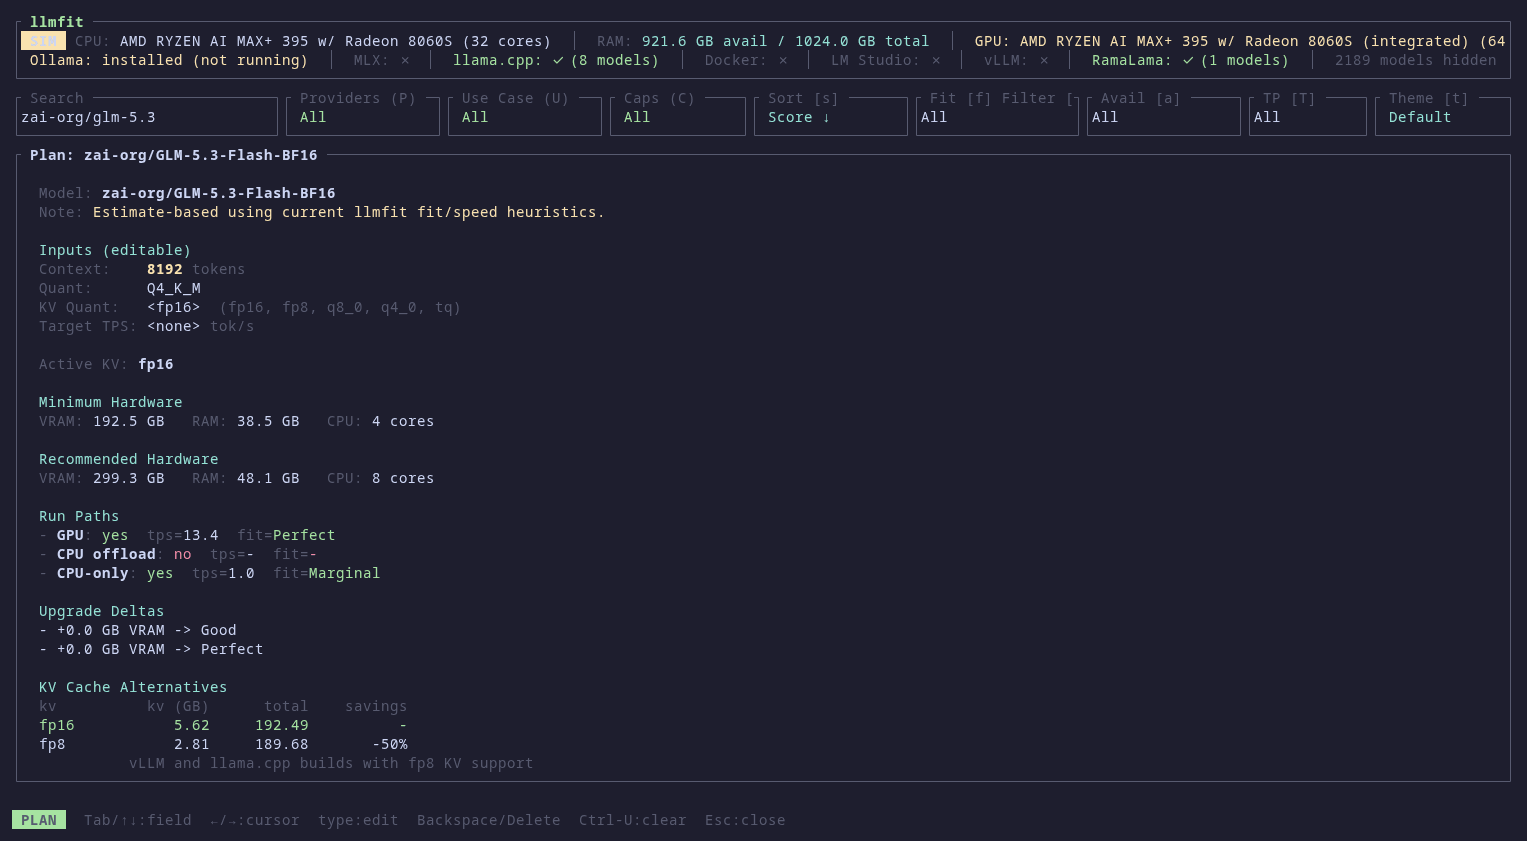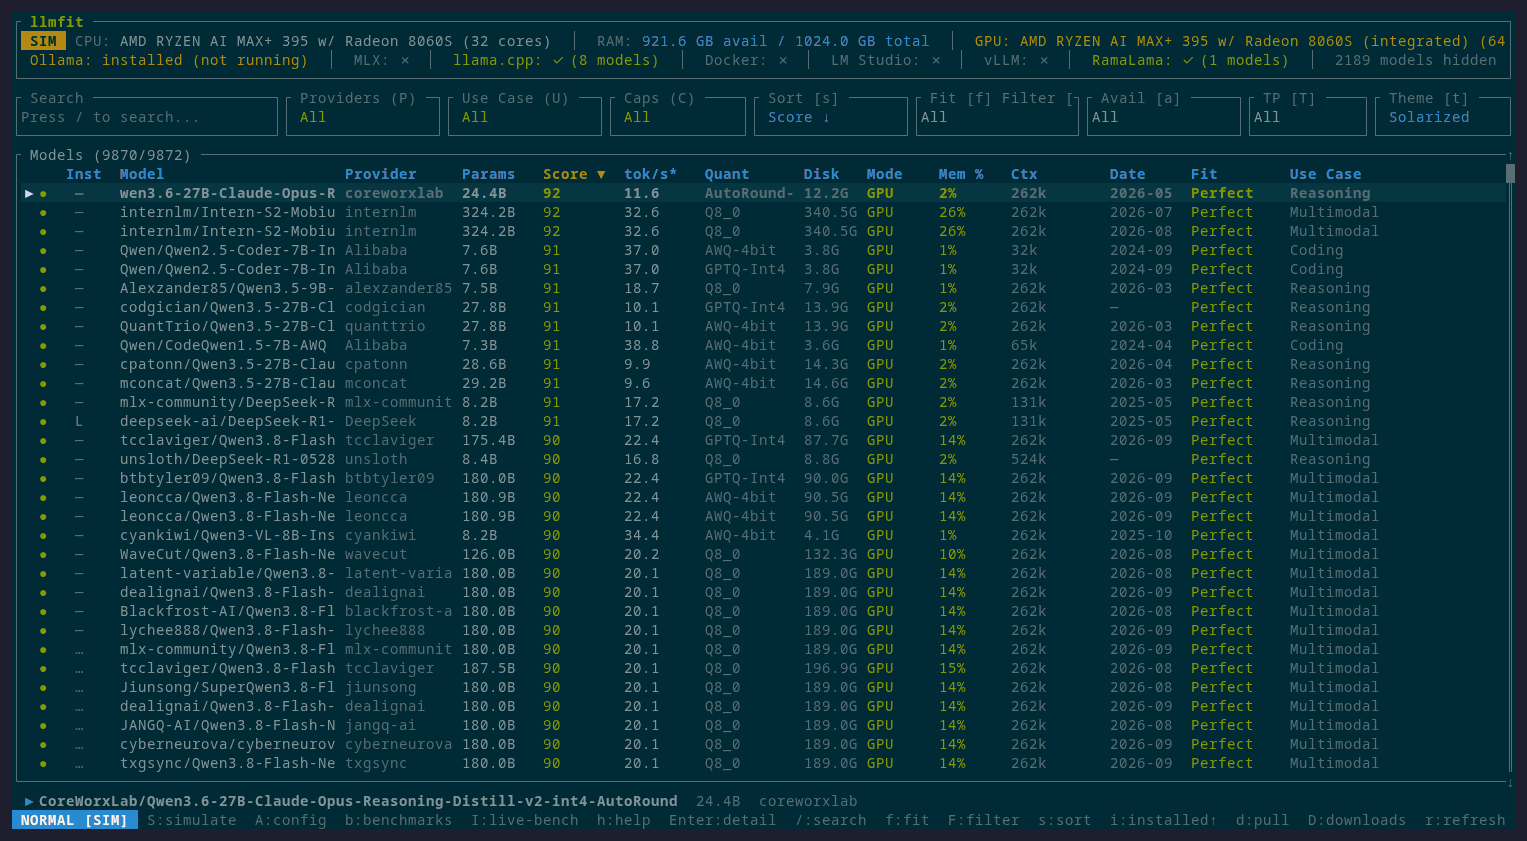
llmfit 是个终端工具,启动后先检测 CPU 核数、内存、独显/集显、显存,以及 Apple Silicon 这类统一内存架构(支持 NVIDIA CUDA、AMD ROCm、Intel OneAPI、Apple Silicon)。然后对内置的模型库逐个打分,维度有四个:内存能不能装下、估算速度、质量、上下文长度。结果按适配程度排好,不用自己去算"7B 的 Q4 要多少显存"。
几个我觉得实用的点:
- 考虑量化格式(GGUF、AWQ、GPTQ、EXL2),同一个模型会给出不同量化下的占用和速度
- 认得 MoE 模型,按激活参数而不是总参数估算速度,这点比不少"显存计算器"靠谱
- 支持多 GPU
- 速度估算基于内存带宽模型,每个数字都能用
llmfit info看到它的输入假设 - 能对接 Ollama、llama.cpp、MLX、Docker Model Runner、LM Studio 这些本地运行时
- 还带一个 Web 面板和 REST 接口(
/api/v1/system、/api/v1/models),脚本和 agent 可以直接调用
最近加的 benchmark 功能也有意思:你可以在本机下载模型、起服务、实测 tok/s,结果会替换表里的估算值,还能从 TUI 里直接提 PR 贡献给社区。以后同样硬件的人会直接看到实测数据。
怎么用
安装方式很多:
scoop install llmfit

brew install AlexsJones/llmfit/llmfit

uv tool install -U llmfit
uvx llmfit        # 不安装直接跑
常用命令:
llmfit                       # 交互式 TUI:你的硬件 + 所有模型,按适配度排序
llmfit fit                   # 经典表格输出
llmfit recommend --json      # 推荐结果输出 JSON,方便脚本/agent 用
llmfit info "<模型名>"        # 单个模型的适配分析和估算依据
llmfit bench                 # 对正在跑的服务实测 tok/s 和首字延迟
llmfit serve --port 8787     # 起 Web 界面和 API
TUI 里 / 可以按名称、家族或量化过滤,h 看帮助。没有显卡的机器也能用,它会按 CPU 和内存给出建议。
放到服务器上当个常驻面板也行,官方有 Docker 镜像:
docker run -d -p 8787:8787 ghcr.io/alexsjones/llmfit serve
适合谁,要注意什么
适合正在选本地模型的人,或者要给一批机器统一规划"每台该跑什么"的人。recommend --json 配合 jq,可以直接做成部署流程里的一步。
要留意的是,没跑 benchmark 之前,速度数字是估算值,不是实测。README 自己也提到,同类的 llm-checker 走的是"通过 Ollama 真跑一遍"的路线,更接近真实表现,但要求先装 Ollama;llmfit 是先从规格估算,省事,代价是精度。两者可以搭着用:先用 llmfit 筛,再对入围的实测。
项目信息
- 语言:Rust
- License:MIT
- Star:截至 2026-10-01 约 3.7 万
- 最新版本:v1.1.16(2026-09-19)
- GitHub:https://github.com/AlexsJones/llmfit
原文发布于 SunAI 论坛。文中版本、Star 数及相对时间均以原帖发布时为准。
最后更新于 2026-10-09
评论 0